凌晨两点,运营群炸了:商品详情页打开要 6 秒,后台订单列表一翻页就卡死。运维扩容、加内存、上 CDN,折腾一圈发现,慢的不是机器,是一张“用户表”里塞了 5 万条浏览记录;MongoDB 官方文档和近年实战复盘都反复提到同一个根因——数据模型不是先画 ER 图,而是先写清楚你的查询。很多人踩坑,不是因为不会 MongoDB,而是把 MySQL 的肌肉记忆原封不动搬了过来。
先把结论压住:一起读的数据,就该一起存
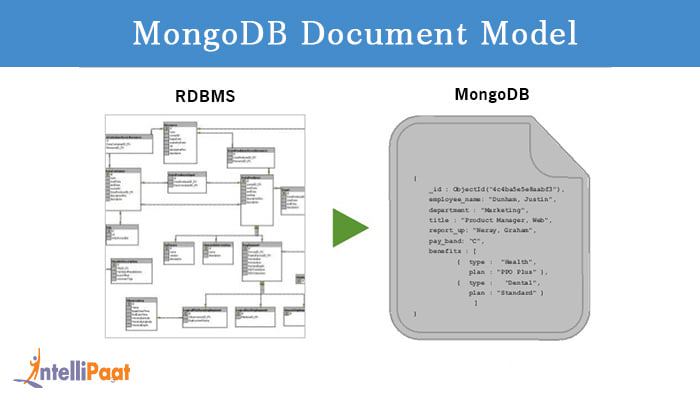
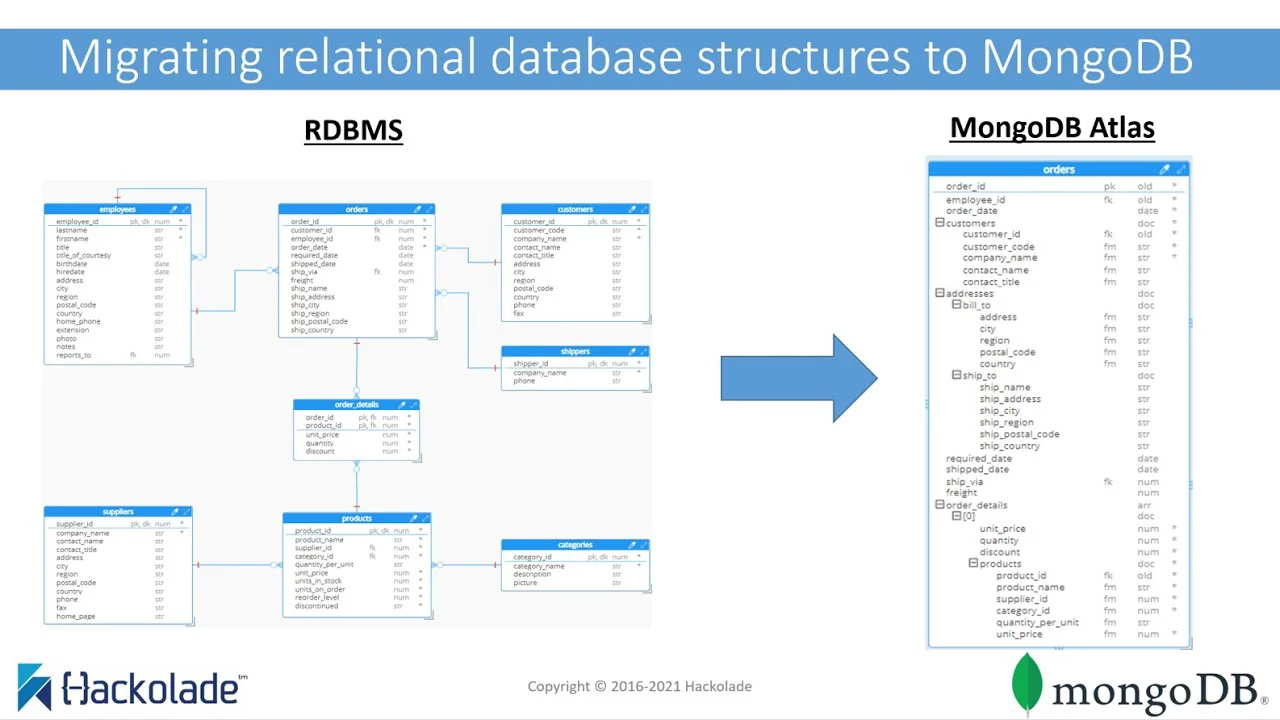
MongoDB 建模的第一性原理很朴素:一起访问的数据应该一起存储。这不是口号,是性能公式。文档模型把一次详情页要读的东西放进同一个文档,磁盘顺序读一次就回家;关系模型拆成七八张表,逻辑很美,查询却要 join 七八次。MongoDB 官方手册在“数据建模最佳实践”里写得直白:根据应用程序的数据访问模式建模,别根据“实体关系”建模。
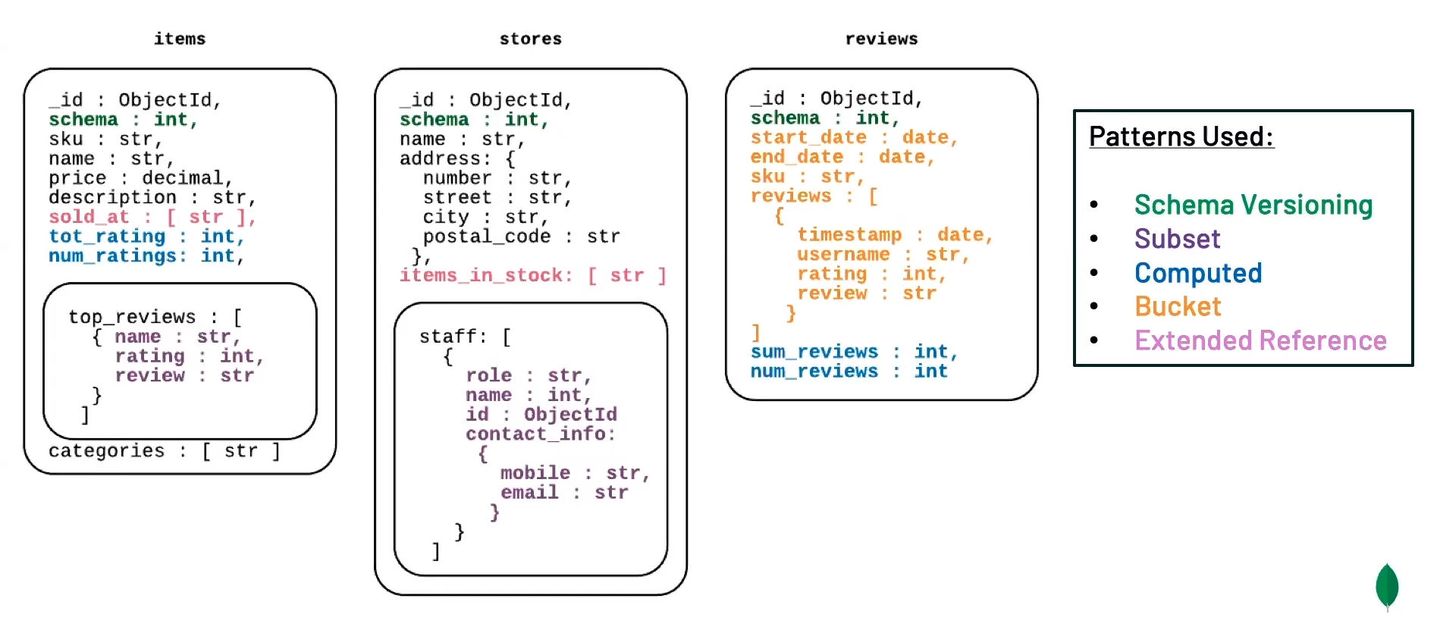
落地动作很土,但很管用:上线前把 Top 20 查询列出来,标出筛选、排序、返回字段、读写比。比如电商商品页要显示“商品 + 最近 5 条好评”,那商品文档里就只嵌最近 5 条,完整评价进独立集合。这不是偷懒,是官方示例同款思路:课程对象开始嵌课时没问题,等课时变成视频、测验、作业、外链的杂烩,就该拆 lessons 集合用 ID 引用。
嵌入还是引用?问四个问题,别拍脑袋
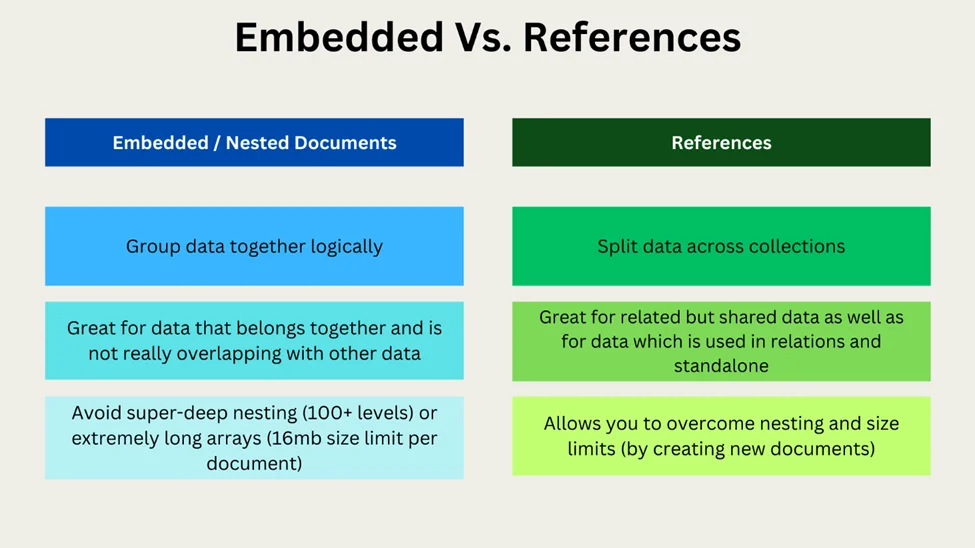
新手上路最爱问“到底嵌还是引”。2025 年 MongoDB 社区论坛里那个“学习计划”帖子很典型:阶段、目标、评论层层嵌套,读计划很快,改一个深层目标却像拆盲盒。更稳的做法是先嵌阶段,再引用目标——读路径保留局部性,写路径不被深嵌套拖死。
判断标准用四问就够:相关数据会不会长得没边?会不会频繁单独改?是不是总和父对象一起读?一个父对象下面会有多少个?四个答案打架时,大小优先:单个 BSON 文档上限 16 MiB,越过这条线写入直接失败。社区复盘里有真实事故:用户会话全塞在用户文档里,重度用户攒到 5 万多条,查询越拖越慢,最后只能拆集合。官方手册也提醒,无界增长数组该用引用、子集或分桶模式收口。
还有一个隐性成本:一致性。单文档写入天然原子;跨文档更新要么拆得好,要么上多文档事务。官方态度很明确:事务更贵,不该替代好模型。复制点数据并不丢人,关键是分清三类副本——创建时间这种“永远不变”的放心复制;下单瞬间的收货地址这种“时间快照”应该复制;库存、余额这种“对陈旧敏感”的副本,要么靠事务和触发器维护,要么干脆别复制。2026 年的 DbSchema 教程给过一个干净利落的小电商模型:订单里复制 unit_price,因为商品现价涨了,也不能改顾客当年付过的钱。
最该守住的四个坑:数组、深嵌套、字段名、索引
先说数组。数组不是收纳箱,是排水口。会话、日志、消息、评论,只要“会随时间一直长”,就别嵌。可行解法是组合拳:最近 N 条用子集模式嵌在主页,历史记录进冷集合;连续流数据用分桶模式,每 500 条或每小时一桶;父对象巨大时改成子文档里放父 ID。这样文档不顶 16 MiB,索引也不会被数组元素撑爆。
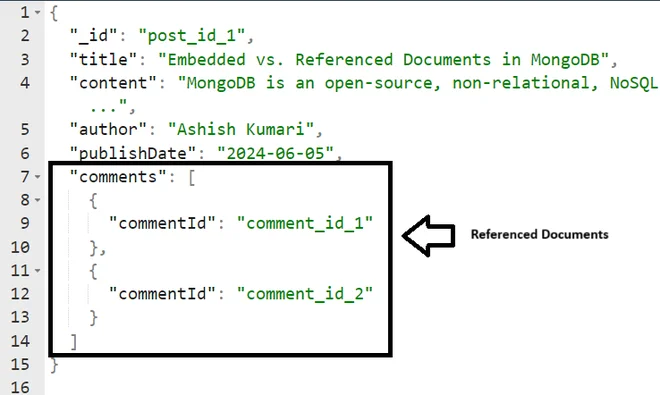
再说深嵌套。MongoDB 支持 100 层嵌套,不代表你应该用满。数组套数组时,普通定位符 $ 够不到里层,得搬出 arrayFilters;一旦更新语句开始绕口令,通常说明这组数据该独立成集合。结构别像千层饼,像文件夹:扁平一点,路径好写,索引好建。
字段名也别清高。BSON 会把字段名存进每条文档,小文档里字段名能占掉一大块。官方例子很直白:last_name 改 lname、best_score 改 score,每条省 9 字节;上亿条就是 GB 级。当然别走火入魔,把 customer_name 缩成 cn 这种自残写法,可读性全没。高吞吐集合里适度缩写,低量集合里保持人话。
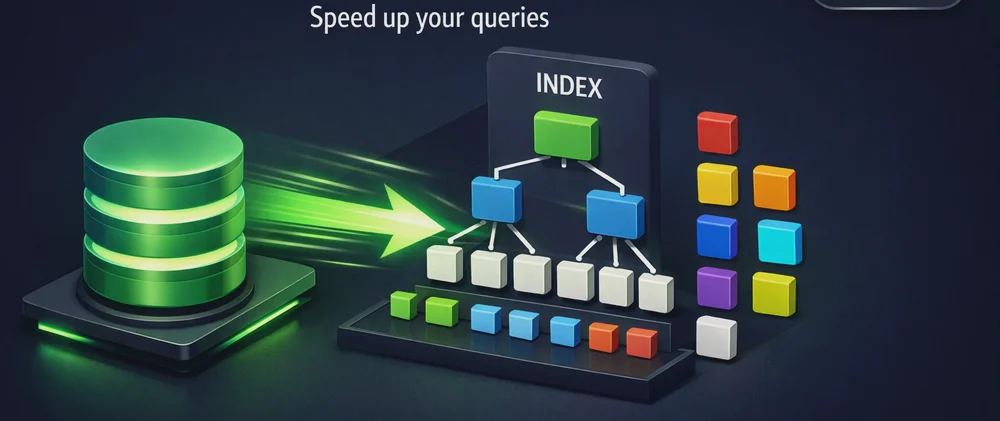
索引是双刃剑。只给真用来筛选、排序、$lookup、$group 的字段建索引;每个索引至少占 8 KB 空间,还会拖慢写入。官方手册原话:高写读比集合里,索引成本很高,因为每次插入都要维护所有索引。生产上要盯 $indexStats 和慢查询,定期删掉没人用的索引。2026 年多篇性能复盘都把“过度规范化导致 $lookup 风暴”和“过度索引导致写入劣化”并列成头号自伤。
模型不是画完就完:验证、演进、生命周期
很多人以为灵活模式等于“随便塞”。恰恰相反,灵活是给你迭代用,不是给你裸奔用。$jsonSchema 验证规则该上就上:start_date 只允许日期类型,accepted_credit_cards 只收 Visa/MasterCard/American Express,gpa 必须是正浮点。MongoDB 默认不拦错误形状,规则就是护栏,否则三个月后你会在日志里看到字符串日期和负数库存互相打架。
演进也要留后路。给文档加 schema_version,别追求一步到位。新字段可以先可选,双写一段,再切读路径;老字段下线前先确认查询、索引、聚合、BI 报表都不碰它。2026 年 dev.to 的实战清单把“版本化 schema”写进最终建议,原因很现实:演化不可避免,装没看见只会把坑留给凌晨。
生命周期管理同样影响模型。登录会话用 TTL,30 分钟不活动自动删;只关心最新写入的日志用固定集合做 FIFO;冷数据归档前,别把热字段和冷字段焊在一个大文档里。工作集尽量贴合 RAM,查询只投影需要的字段。不然内存一紧,磁盘一介入,再漂亮的嵌套也会现形。
这几年的风向:从“手艺”变成“可治理”
新趋势不是某个神秘语法,而是建模开始被当成可审计资产。MongoDB 官方与 Hackolade 一类工具强调反向工程、可视化、模式文档化;AI 插件市场也出现了 MongoDB schema-design skill,把最佳实践和反模式打包成可复用检查清单。对普通团队来说,价值不在“AI 替你设计”,而在每次改模型都留下证据:查询清单、字段字典、验证规则、索引评审、迁移窗口。
更实际的变化是混合模型常态化:不是“全嵌”或“全引”的宗教战争,而是热路径嵌、冷数据引、快照复制、可变字段隔离。一个产品文档里保留标题、类目、最近评分;详情、评论、库存流水各归其位。读起来像常识,做起来要纪律。
数据库选型常见,数据模型被认真对待不常见。MongoDB 不惩罚你拆表,它惩罚你把所有答案塞成一个“看起来省事”的文档。下次评审设计时,只问一句:这条查询真正需要哪些字段一起回来?答得出来,模型就赢了一半。
资料参考:MongoDB 官方手册 Data Modeling / Best Practices、MongoDB Community Forums 2025 schema design 讨论、dev.to 2026《MongoDB Schema Design: Do’s and Don’ts》、DbSchema 2026《MongoDB Schema Design Best Practices》。